Javaのメソッドを分ける基準は、行数よりも「名前を付けて説明できる仕事のまとまり」です。まず同じクラスのprivateメソッドへ切り出し、取込の進行と、1行を変換する規則を分けます。別クラスにするかは、その規則を独立した担当として扱う理由があるかで判断します。
この記事でわかること
- 長いメソッドのどこを切り出し、呼び出し元に何を残すか。
privateメソッドで十分な場合と、別クラスにする場合の違い。- 分割で動作を変えていないか、保存回数と失敗する入力で確かめる方法。
レビューで「長いから分けて」と言われても、30行ずつ切れば読みやすくなるとは限りません。途中の変数やフラグを次のメソッドへ大量に渡すと、むしろ呼び出し先を何度も往復することになります。この記事は、class・new・メソッド呼び出しは読めるものの、どの処理を同じ場所に置くかを決められない人向けです。
題材は架空のアカウント取込です。Springを使わず、正しく動く同じ処理を3通りに並べます。CSVを解析するコードやDB接続を増やすのではなく、変換と保存の境目だけを追ってください。
分割前:1行の変換と、取込全体の進行が同じメソッドにある
入力はCSV解析が済んだList<String[]>です。各行はメールアドレスと契約数の2列で、ヘッダーは含めません。配列と各要素は非nullを前提にし、前後の空白は自動で削除しません。メールは空白だけでないこと、契約数は整数として読める1以上の値であることを確認します。
変換結果はAccountにまとめます。次がsrc/Account.javaの全文です。recordは、ここではメールと契約数をひとまとまりの値として保持するために使います。業務上の検証をすべて備えたアカウントモデルではありません。
public record Account(String email, int seats) {}次がsrc/BeforeImporter.javaの全文です。先に「1行をAccountへ変える部分はどこからどこまでか」「保存を呼ぶのはいつか」を探してから、説明へ進んでください。
import java.util.ArrayList;
import java.util.List;
import java.util.function.Consumer;

public final class BeforeImporter {
    public void importAccounts(List<String[]> rows, Consumer<List<Account>> save) {
        var accounts = new ArrayList<Account>();
        for (String[] row : rows) {
            if (row.length != 2 || row[0].isBlank()) {
                throw new IllegalArgumentException("列数またはメールが不正");
            }
            int seats = Integer.parseInt(row[1]);
            if (seats < 1) {
                throw new IllegalArgumentException("契約数は1以上");
            }
            accounts.add(new Account(row[0], seats));
        }
        save.accept(accounts);
    }
}forの中には、列数とメールの確認、契約数の数値変換、1以上かの確認、Accountの生成があります。これらはまとめて「解析済みの1行から、保存へ渡すAccountを作る」仕事です。一方、accountsに全行の結果を集め、最後にsave.accept(accounts)を呼ぶ部分は、取込全体の順序を決めています。
Consumer<List<Account>>は、一覧を受け取って処理する関数です。この例では保存担当を外から渡し、acceptで呼びます。配布した検証コードは実DBへ書き込まず、呼ばれた回数と渡された値を記録します。「保存を呼ぶ場所」を確認するための差し替えです。
まずprivateメソッドへ切り出し、呼ぶ側に順序を残す
1行の変換をtoAccountへ移すと、次のsrc/MethodImporter.javaになります。全文を載せています。クラス名は3版を並べて実行するために変えていますが、受け付ける入力と保存する結果は変えていません。
import java.util.ArrayList;
import java.util.List;
import java.util.function.Consumer;

public final class MethodImporter {
    public void importAccounts(List<String[]> rows, Consumer<List<Account>> save) {
        var accounts = new ArrayList<Account>();
        for (String[] row : rows) {
            accounts.add(toAccount(row));
        }
        save.accept(accounts);
    }

    private Account toAccount(String[] row) {
        if (row.length != 2 || row[0].isBlank()) {
            throw new IllegalArgumentException("列数またはメールが不正");
        }
        int seats = Integer.parseInt(row[1]);
        if (seats < 1) {
            throw new IllegalArgumentException("契約数は1以上");
        }
        return new Account(row[0], seats);
    }
}呼び出し元のimportAccountsだけを読むと、全行を変換して一覧に集める → まとめて保存するという順序が分かります。列数の判定や数値変換の細部は、変換規則を調べたいときにtoAccountを開けば確認できます。行数を減らすためだけでなく、取込の流れと変換の細部を、読む目的に合わせて分けた形です。
切り出したメソッドの境界は、入力がString[] row、出力がAccount、不正なときは例外です。途中のseatsや判定済みフラグを呼び出し元へ返す必要はありません。完成した1件を返せるため、呼ぶ側は変換の途中経過を知らずに済みます。
一方、checkColumn、checkEmail、parseSeats、checkSeatsへ機械的に細分化することを、最初の目標にはしません。それぞれを独立させる理由がなければ、1行を作るための処理が散らばります。例えばメール検証だけが複雑で、専用の変更や確認が必要になった段階なら、そのまとまりをさらに分ける理由になります。
privateにするのは、この段階では同じクラスの取込処理だけが使うためです。他から呼べる必要がないものを、先回りしてpublicにしません。「再利用しないからメソッドにしない」でもありません。名前で処理の意図を伝え、読む場所を絞れること自体に意味があります。
分割だけなら、保存回数と失敗するタイミングを変えない
この例で特に残すべきなのは、全行の変換が成功するまで、保存を呼ばないことです。1行目が正常で2行目のメールが空なら、どちらの版も2行目で例外になり、save.acceptへ到達しません。変換済みの1行目はメモリー上の一覧にあるだけです。
「1行分をまとめたい」と考えて、変換と保存を両方ループ内へ移すと、同じ分割にはなりません。2行目で失敗する前に、1行目の保存を呼ぶ動作へ変わります。入力が正常なときの最終一覧だけを比較しても、この違いは見落とします。
維持する順序:全行を変換 → 一覧を保存(1回)
別の動作になる:1行を変換 → その行を保存 → 次の行へ保存を1回呼ぶことと、DBへの書き込みが全部成功するか全部取り消されることは、別の保証です。保存の内部でエラーになった場合のロールバックは、この例では確認していません。この記事のサンプルが保証するのは、保存関数を呼ぶまでの順序と回数です。
空の一覧の扱いも、見た目の整理と一緒に変えないでください。現行の約束は、空の入力でも空リストで保存を1回呼ぶことです。「何もないならreturnする」を追加すると保存0回へ変わります。業務として0回が適切なら、その仕様変更として確認してから変えます。
別クラスにするなら、変換担当を独立させる理由を示す
今ある要求がこの取込1本だけで、変換規則も短いなら、ここまでのprivate toAccountで十分です。行が減ったことを理由に、さらにHelperを作る必要はありません。まず「何を担当するクラスか」「何が変わったときに、そのクラスを直すか」を具体的にします。
例えば、同じ解析済みの行から、保存前のプレビューでもAccountを作る要求が増えたとします。プレビューは保存しませんが、列数や契約数の確認は実際の取込と揃えたい。この条件なら、取込に閉じた変換規則をAccountMapperへ出し、プレビューと取込が同じ変換担当を使う理由があります。これは別クラスにする理由を考えるための追加要求例です。配布サンプルには変換担当を取り出した取込処理までを含め、プレビューの画面・実行処理は実装していません。
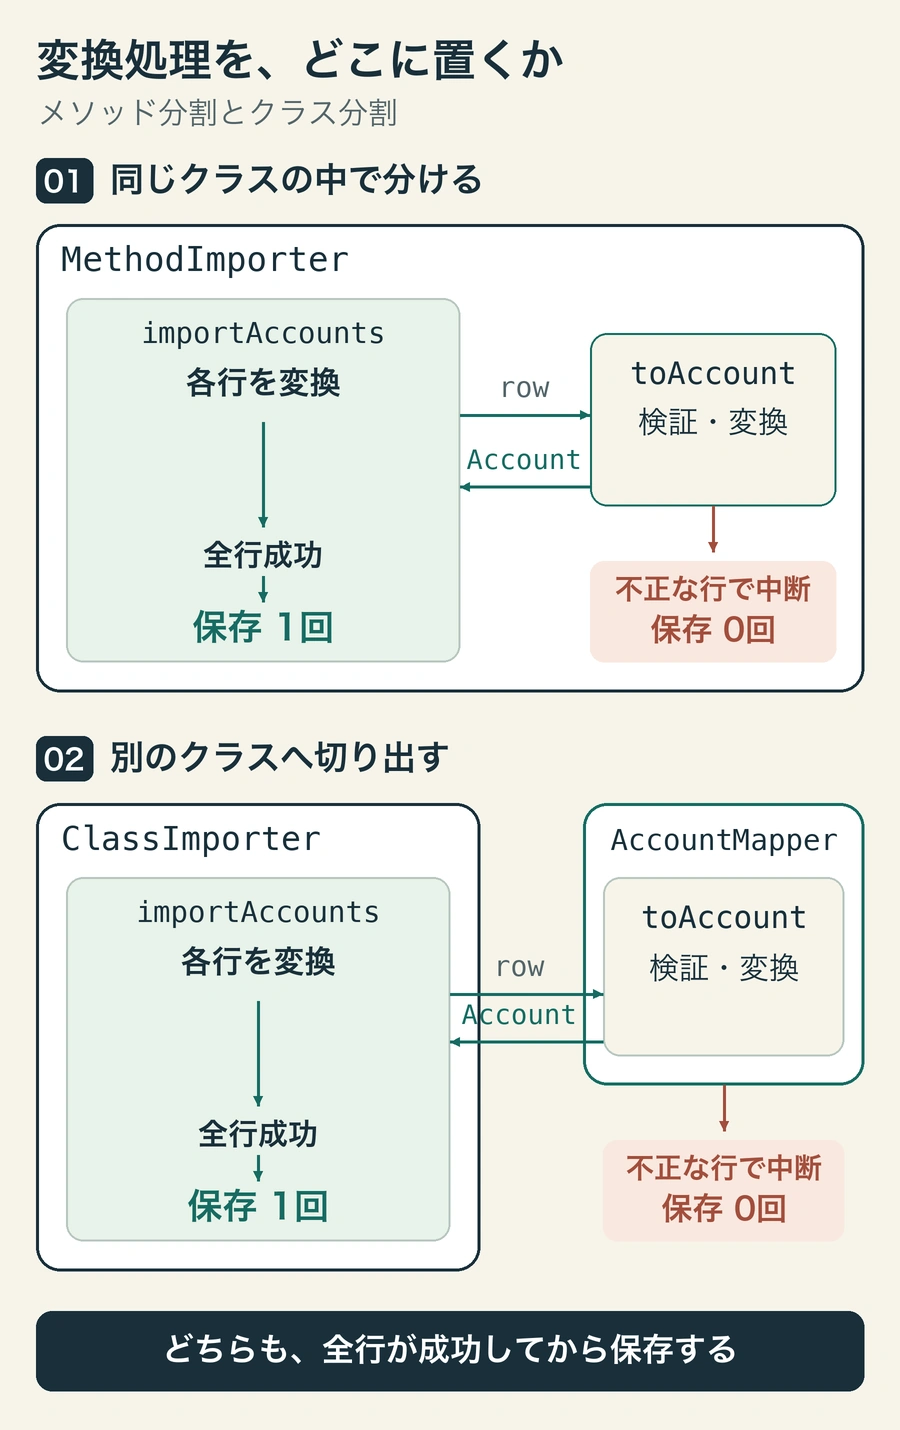
次がsrc/ClassImporter.javaの全文です。コンストラクターで受け取ったAccountMapperを保持し、各行をmapper.toAccount(row)へ渡します。保存の位置は、メソッド分割版と同じくループの後です。SpringやDIコンテナーの設定は使っていません。
import java.util.ArrayList;
import java.util.List;
import java.util.function.Consumer;

public final class ClassImporter {
    private final AccountMapper mapper;

    public ClassImporter(AccountMapper mapper) {
        this.mapper = mapper;
    }

    public void importAccounts(List<String[]> rows, Consumer<List<Account>> save) {
        var accounts = new ArrayList<Account>();
        for (String[] row : rows) {
            accounts.add(mapper.toAccount(row));
        }
        save.accept(accounts);
    }
}呼び出し側は、標準のnew AccountMapper()を渡して組み立てます。次は配布コードに対応する組み立て方です。ClassImporterが変換規則を内部で作り込まず、必要な変換担当を渡される関係が見えます。
var importer = new ClassImporter(new AccountMapper());AccountMapperが受け取るのは1行、返すのはAccountです。保存や取込の繰り返しは担当しません。次のコードは、src/AccountMapper.javaにあるtoAccountメソッドの抜粋です。maxSeatsの設定も含むクラス全文は、冒頭のGitHubから確認できます。
    public Account toAccount(String[] row) {
        if (row.length != 2 || row[0].isBlank()) {
            throw new IllegalArgumentException("列数またはメールが不正");
        }
        int seats = Integer.parseInt(row[1]);
        if (seats < 1) {
            throw new IllegalArgumentException("契約数は1以上");
        }
        if (seats > maxSeats) {
            throw new IllegalArgumentException("契約数は" + maxSeats + "以下");
        }
        return new Account(row[0], seats);
}標準のnew AccountMapper()では、上限にInteger.MAX_VALUEを設定しています。これはintで表せる最大値なので、標準版で受け付ける契約数は、分割前と同じ「整数として読める1以上」です。101も受け付けます。上限を変えるコンストラクターは、次の章の追加要求用です。
利用先が2つになることは分ける理由の一例で、必須条件ではありません。呼び出し元が1つでも、業務規則と専用の設定がまとまり、保存手順とは別に変更・確認したいなら独立させる価値があります。反対に、別クラスへ出した後も取込側の途中変数を何個も渡すなら、境目がずれていないか見直します。
契約数を1〜100へ変えるなら、変換規則を変更する
ここからは分割だけの話と分けて、「この取込で受け付ける契約数を1〜100にする」という追加要求を考えます。101は標準版では正常、追加要求では不正です。正解が変わるため、分割前後の同値確認に混ぜません。
配布サンプルでは、この追加要求をnew AccountMapper(100)で表せるようにしています。AccountMapperのコンストラクターで上限を受け取り、変換時のseats > maxSeatsで確認します。ClassImporter.importAccountsの全行変換と保存の順序は変更しません。
// 上限100は、分割とは別の追加要求
var importer = new ClassImporter(new AccountMapper(100));この配布コードで上限を選ぶ場所は、SampleVerification.javaの組み立て部分です。標準3版の比較はnew AccountMapper()のまま、追加仕様の確認だけnew AccountMapper(100)を使っています。値を指定する場所と、上限を判定する場所を区別してください。既定値を100へ書き換えると、標準版まで別仕様になります。
この形を選ぶ理由は、入力確認の規則を担当するAccountMapperへ上限をまとめ、取込手順へ判定を散らさないためです。あらゆる業務ルールを引数で切り替える汎用クラスを勧めているわけではありません。上限が業務全体で一つに固定される設計なら、規則の担当にその値を持たせる方法もあります。今回のサンプルは、標準版と追加要求を同時に比較するため、生成時に指定しています。
確認するのは、1と100を受け付け、0と101を拒否することです。さらに「1行目は1、2行目は101」の入力では、保存0回で失敗することも確認します。境界の判定だけ正しくても、不正な行より前のデータを保存してしまうなら、取込の約束は守れていません。
同じ入力で3版を実行し、値・保存回数・例外を比べる
ZIPを展開し、READMEがあるmethod-or-classフォルダで次を実行します。JDK 17が必要です。Maven、JUnit、DBは不要で、サンプル自体に外部ライブラリはありません。srcには記事の6つのJavaファイルが入っています。
mkdir -p out
javac -encoding UTF-8 -d out src/*.java
java -cp out SampleVerificationSampleVerification.javaは、同じ入力を3版へ渡し、期待する結果と比較する実行入口です。比較するのは正常時のAccount一覧だけではなく、保存回数・値の順序・例外の型とメッセージです。違えばAssertionErrorで停止します。Javaのassert文に依存していないため、-eaの指定は不要です。
| 標準版で渡す入力 | 3版で揃える結果 |
|---|---|
| 正常な2行 | 同じ値・入力順の一覧で保存1回 |
| 先頭または途中のメールが空 | 例外。保存0回 |
| 契約数が数値でない/0/負数 | それぞれの例外。保存0回 |
| 列が不足/余分 | 例外。保存0回 |
| 空の入力一覧 | 空リストで保存1回 |
| 契約数101/intの最大値 | 標準仕様では正常。保存1回 |
標準11ケースを3版で実行して33件、上限100の追加要求を6ケース確認して、合計39件です。最後に次の表示になります。baselineが同じ仕様の比較、extensionが上限100の別仕様です。件数を合算して、39種類の入力を網羅したという意味にはしません。
OK: baseline 11 cases x 3 versions = 33 checks; extension 6 checks; total 39 checks.この結果はJava 17.0.8で確認しています。GitHubで配布しているZIPもダウンロード・展開して同じコマンドを実行しました。CSVの引用符や文字コード、実DB、同時実行は対象外です。保存を一行ずつ呼ぶ誤った変更を入れると検証が失敗することも確認し、分割しただけで保存のタイミングが変わる問題を検出できるようにしました。
「今回はクラスを増やさない」と理由を説明できるか
レビューでは、「きれいになった」「責務を分けた」で止めず、今回の要件、選択肢、採用理由、他の方法を選ばなかった理由まで説明します。この例なら、次のように話せます。
今回の要求は、取込の流れを読みやすくすることです。1行の変換をprivateのtoAccountへまとめました。変換を別の入口から使う要求はなく、処理もここで追えるため、今回はクラスを増やしていません。全行を変換した後の保存1回と、不正行がある場合の保存0回は、同じ入力で確認しています。
プレビューでも同じ変換を使う要求があるなら、採用理由は変わります。「プレビューと取込で判定がずれないようAccountMapperへ集め、取込の順序はClassImporterへ残した」と説明できます。どちらも同じ行数ルールで機械的に決まるものではなく、実際に揃える必要がある規則と、その利用場所から決めます。
細分化した後、process1やdoNextという名前しか付かないなら、切り出した仕事を説明できていない可能性があります。逆に、たとえ実装が1行でも、名前で呼ぶ側の意図を表せるなら、短さだけで不要とは決められません。チームの規約がある場合も、行数だけで終わらせず、この具体的な不都合や利点を判断材料にします。
分割を出す前に、読む場所と変わらない動作を確認する
- 切り出した仕事の入力・出力・失敗を、一文で説明できる。
- 呼び出し元には全体の順序が残り、途中のフラグを追わなくてよい。
- 別クラスにする場合、名前と担当、別々に変わる理由を説明できる。
- 同じ入力で、保存する値と順序だけでなく保存回数と例外も比較した。
- 空入力や途中行の不正など、正常系以外の動作を勝手に変えていない。
- 分割と仕様変更を区別し、上限100のような追加条件は別の確認にした。
名前を付けても役割がぼやける、データと規則をどのクラスへ集めるかで止まる人には、『改訂新版 良いコード/悪いコードで学ぶ設計入門』が候補になります。目的ごとのメソッド化、関係するデータとロジックのまとめ方、カプセル化を学ぶ本です。今回のコードを覚えるためではなく、自分のコードで変更理由を説明するために使います。

改訂新版 良いコード/悪いコードで学ぶ設計入門
レビューで直される理由を、Javaの具体例から理解する。
命名、責務、クラス設計、不変性などを良い例と悪い例で比較できます。現場のコードレビューと結びつけやすい一冊です。
- 設計の悪さを具体例から学びたい
- レビュー指摘の判断軸を増やしたい
当サイトはAmazonアソシエイト・プログラムの参加者です。価格・在庫・配送条件はAmazonでご確認ください。
この記事とあわせて読みたい
分けるのは、行数ではなく読む目的と変更理由
まず、1行からAccountを作る処理を名前で表し、取込側へ全行変換→保存の順序を残す。変換を独立した担当として扱う要求が出たら、AccountMapperへ移す。どちらを選んでも、分割だけの段階では保存回数や失敗のタイミングを変えない。この順番なら、ファイルが増えたことではなく、何を読むとき、何を直すときに助かる分割かをコードで説明できます。
