この記事でわかること
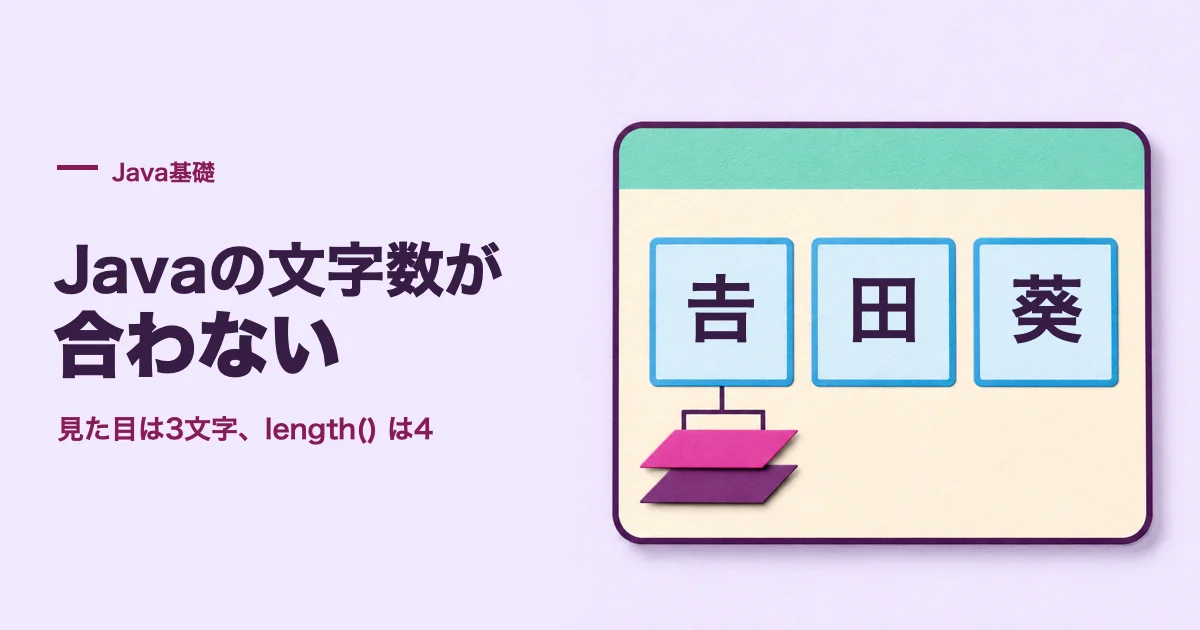
Javaで「𠮷田葵」を length() で数えると4になります。表示名の仕様が「Unicodeコードポイント3個まで」なら、codePointCount() で3と数えます。入力例を使って不具合を再現し、見た目の一文字やUTF-8バイト数が要件のときの違いも確認します。


取引先の連絡先データを取り込む管理画面で、表示名の検証を担当する場面を考えます。テストデータは「田中葵」と「𠮷田葵」です。前者だけを使った結合テストでは、どちらの数え方でも3になるので不具合は見つかりません。連携先が受け付ける氏名を、取り込む前にこちらのシステムが拒否しているのが問題です。
実行サンプル
修正前後の表示名チェック、14件のJUnit、pom.xml、READMEを収録。JDK 17とMavenで、ZIPを展開して mvn clean test を実行します。続いて java -Dfile.encoding=UTF-8 -cp target/classes example.displayname.DisplayNameDemo を実行すると、同じ入力で四つの数え方を比較できます。
「𠮷田葵」を登録すると、3文字の上限で弾かれる
このサンプルでは、連携先が表示名を Unicodeコードポイント1〜3個と定めています。値がない、空文字、空白だけなら必須エラーです。前後の空白を自動で取り除かず、名前の表記も変えません。サンプルは、正しくデコードされたJavaの文字列が判定に渡るところから始めます。
受付可否を再現する DisplayNameDemo.java では、acceptsBefore() が修正前の検証です。必須の判定は済んでいますが、上限に使う name.length() <= 3 が「コードポイント3個まで」という仕様と食い違います。main() は修正前と修正後を同じ入力で実行し、その下で数え方を比較します。
package example.displayname;
import java.nio.charset.StandardCharsets;
import java.util.regex.Pattern;
public final class DisplayNameDemo {
private static final Pattern GRAPHEME = Pattern.compile("\\X");
private DisplayNameDemo() {
}
static boolean acceptsBefore(String name) {
if (name == null || name.isBlank()) {
return false;
}
return name.length() <= 3;
}
public static void main(String[] args) {
String name = "𠮷田葵";
System.out.println("name=" + name);
System.out.println("before=" + acceptsBefore(name));
System.out.println("after=" + DisplayNameValidator.accepts(name));
System.out.println("text | UTF-16 | code points | graphemes | UTF-8 bytes");
for (String text : new String[] {name, "😀", "e\u0301", "👩💻"}) {
System.out.printf("%s | %d | %d | %d | %d%n",
text, text.length(), text.codePointCount(0, text.length()),
GRAPHEME.matcher(text).results().count(),
text.getBytes(StandardCharsets.UTF_8).length);
}
}
}実行すると、name=𠮷田葵、before=false、after=true の順に出ます。「𠮷」は人名で使われる漢字なので、絵文字を受け付けない項目でも同じ種類の不具合は起こり得ます。
length() はUTF-16の単位を数えるので「𠮷」だけで2になる
Javaの String.length() が返すのはUTF-16のコード単位数です。「田」と「葵」はそれぞれ1単位。「𠮷」(U+20BB7)は2単位を組み合わせて表します。この組をサロゲートペアと呼びます。length() は 2 + 1 + 1 で4を返します。Unicodeのコードポイントで数える場合は、「𠮷」の組を1個として 1 + 1 + 1 で3です。
もし調査中に「𠮷」と「吉」(U+5409)を取り違えると、どちらも通るように見えます。実際の障害で再現する際は、ログに氏名をそのまま出さず、再現用の文字列を用意して、UTF-16とコードポイントの値を比べます。仕様は Java 17のString API で確認できます。
codePointCount() で数え、空欄判定と上限判定を分ける
修正版は DisplayNameValidator.java です。codePointCount(0, name.length()) で文字列全体を対象にします。開始と終了の引数はJavaの文字列内の位置なので、終点には length() を渡します。その戻り値であるコードポイント数を上限と比較します。上限ぎりぎりの3個も通すため、比較は <= です。
package example.displayname;

public final class DisplayNameValidator {
    private static final int MAX_CODE_POINTS = 3;

    private DisplayNameValidator() {
    }

    public static boolean accepts(String name) {
        if (name == null || name.isBlank()) {
            return false;
        }
        return name.codePointCount(0, name.length()) <= MAX_CODE_POINTS;
    }
}空白だけでもコードポイントが1個以上あることがあります。必須条件の name == null || name.isBlank() を先に処理し、その後で上限を数えると、どちらの仕様を変更するのかレビューしやすくなります。このサンプルは前後の空白を残すので、たとえば「葵」の左右に半角スペースがあれば、上限判定では3個として扱います。

「画面で一文字」と「連携先の一文字」は同じとは限らない
「絵文字も1文字として数えて」とだけ言われたとき、単体の 😀 だけで仕様を確認すると判断を誤ります。たとえば 👩💻 は「女性」「ゼロ幅接合子」「パソコン」の3コードポイントで、対応する表示環境ではひとまとまりに見えます。e と結合用アクセント(U+0301)を続けた é も、2コードポイントですが、通常は一文字に見えます。
| 入力 | UTF-16の単位 | コードポイント | 拡張書記素クラスタ | UTF-8バイト |
|---|---|---|---|---|
| 𠮷田葵 | 4 | 3 | 3 | 10 |
| 😀 | 2 | 1 | 1 | 4 |
| é(e+結合アクセント) | 2 | 2 | 1 | 3 |
| 👩💻 | 5 | 3 | 1 | 11 |
- API仕様がコードポイント数を指定する場合は、
codePointCount()で数えます。今回の表示名が該当します。 - 利用者が見た目で数えた文字に合わせる場合は、拡張書記素クラスタを候補にし、複合絵文字などの期待値を確認します。表はJava 17の正規表現
\Xで数えています。画面側とサーバー側で実装が異なるなら同じ入力で試します。 - 外部ファイルがUTF-8のバイト数を指定する場合は、
getBytes(StandardCharsets.UTF_8).lengthで比較します。表の「𠮷田葵」は3コードポイントでも10バイトなので、UTF-8で最大9バイトなら入りません。
画面の残り文字数、APIの入力制約、DBや固定長ファイルの上限は、適用する境界ごとに仕様を確認します。たとえば画面がUTF-16単位で3まで、APIがコードポイントで3までなら、サーバーを修正してもブラウザで「𠮷田葵」の最後の字を入力できないことがあります。画面のカウンター、入力制御、保存結果を一度に試すとズレを切り分けられます。書記素の用語は Unicodeの文字境界仕様、Javaでの実装例は Java 17のPattern API にあります。
上限の内外に「𠮷」や絵文字を入れて数え方まで確かめる
「田中葵」だけでは length() に戻してもテストが通ります。上限と同じ3コードポイントの「𠮷田葵」と「A😀B」を許可、4コードポイントの「𠮷田葵子」を拒否にします。前後に計3個の半角スペースを置いた「 葵 」も、4コードポイントなので拒否です。さらに「A👩💻」は見た目で2個に見えますが4コードポイントなので拒否です。誤って書記素数に切り替えた場合にも、仕様との差がこのケースで分かります。
JUnitは14件です。内訳は、修正前の不具合の再現1件、許可5件、上限超過4件、必須違反4件です。修正版を length() に戻すと、許可5件のうち「𠮷田葵」と「A😀B」の2件が失敗します。通常の名前の試験と合わせると、上限判定の有無と、その単位の両方を検証できます。
DisplayNameValidatorTest.javaの全文を見る
package example.displayname;
import org.junit.jupiter.api.Test;
import org.junit.jupiter.params.ParameterizedTest;
import org.junit.jupiter.params.provider.NullAndEmptySource;
import org.junit.jupiter.params.provider.ValueSource;
import static org.junit.jupiter.api.Assertions.assertFalse;
import static org.junit.jupiter.api.Assertions.assertTrue;
class DisplayNameValidatorTest {
@Test
void oldValidatorRejectsJapaneseNameAtTheLimit() {
assertFalse(DisplayNameDemo.acceptsBefore("𠮷田葵"));
}
@ParameterizedTest
@ValueSource(strings = {"葵", " 葵 ", "田中葵", "𠮷田葵", "A😀B"})
void acceptsUpToThreeCodePoints(String name) {
assertTrue(DisplayNameValidator.accepts(name));
}
@ParameterizedTest
@ValueSource(strings = {" 葵 ", "𠮷田葵子", "😀😀😀😀", "A👩💻"})
void rejectsMoreThanThreeCodePoints(String name) {
assertFalse(DisplayNameValidator.accepts(name));
}
@ParameterizedTest
@NullAndEmptySource
@ValueSource(strings = {" ", " "})
void rejectsMissingAndBlankNames(String name) {
assertFalse(DisplayNameValidator.accepts(name));
}
}pom.xmlの全文を見る
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
  <modelVersion>4.0.0</modelVersion>
  <groupId>example</groupId>
  <artifactId>java-string-length-code-point-count</artifactId>
  <version>1.0.0</version>
  <properties>
    <maven.compiler.release>17</maven.compiler.release>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
  </properties>
  <dependencies>
    <dependency>
      <groupId>org.junit.jupiter</groupId>
      <artifactId>junit-jupiter</artifactId>
      <version>5.12.2</version>
      <scope>test</scope>
    </dependency>
  </dependencies>
  <build>
    <plugins>
      <plugin>
        <groupId>org.apache.maven.plugins</groupId>
        <artifactId>maven-compiler-plugin</artifactId>
        <version>3.14.1</version>
      </plugin>
      <plugin>
        <groupId>org.apache.maven.plugins</groupId>
        <artifactId>maven-surefire-plugin</artifactId>
        <version>3.5.3</version>
      </plugin>
    </plugins>
  </build>
</project>レビューでは「3文字の定義」と「上限で通る入力例」を揃える
仕様書が「表示名は3文字まで」だけなら、開発者がコードを読んで仕様を決めることになります。画面チームと連携担当に例を渡し、「𠮷田葵は許可されますか」「A👩💻は許可されますか」「既存の連携先はどの単位で検証しますか」と聞くと、実装と受入テストの両方へ回答を反映できます。
連携仕様の上限はUnicodeコードポイント3個です。
length()では「𠮷田葵」が4になって拒否されるので、codePointCount()に変えました。上限ちょうどの「𠮷田葵」は通し、4コードポイントの「𠮷田葵子」は拒否することをテストで確認しています。
- 最大値の横に、UTF-16の単位・コードポイント・書記素クラスタ・バイト数のどれかを書いた。
- 同じ上限に対し、数え方を間違えると結果が変わる実例を1件以上追加した。
- 空欄の扱いと、前後の空白を残すかを別々に確かめた。
- 画面表示と保存の両方を担当する場合は、同じ値で入力から保存まで試した。
文字列操作の基本を読み直したいときの1冊
今回のコードで「文字列そのもの」と「長さや位置を返すメソッド」の区別に迷ったら、『スッキリわかるJava入門 第5版』の文字列を扱う章が次の一歩です。読みながら、同じ文字列に対する length() の値と、codePointCount() に渡す開始・終了位置を説明してみると、引数の位置と戻り値の単位を分けて読めるようになります。

スッキリわかるJava入門 第5版
変数・条件分岐から、クラスの基本まで学ぶ一冊。
豊富な図とサンプルで、変数、条件分岐、クラス、例外処理まで順番に学べます。Javaの最初の教科書を探している人向けです。
- Javaを基礎から体系的に学びたい
- Java 25 LTS対応の入門書を選びたい
当サイトはAmazonアソシエイト・プログラムの参加者です。価格・在庫・配送条件はAmazonでご確認ください。
この記事とあわせて読みたい
まとめ
今回の連携仕様では「𠮷田葵」は3コードポイントなので通します。Javaの length() が4を返す理由は「𠮷」がUTF-16の2単位を使うからです。次に上限を直すときは、先に連携仕様の単位を確かめ、普通の名前だけでは検出できない入力を上限ちょうどに置いてください。
